AI4AIR:大模型赋能 AI 研究综述分享
发布时间:
文章目录
导读
在大模型深度赋能科研的当下,有一个问题似乎被忽略:对于 AI 研究者来说,这个由他们亲手发明和训练出来的大模型,是如何反过来辅助自己的?
近两年来,以大语言模型(LLM)为代表的生成式 AI 正凭借强大的生成与逻辑推理能力,引发 AI 研究工作流的底层范式变革。大模型已深度嵌入文献检索、代码编写和假设生成等环节。区别于传统学科,由于 AI 研究的核心资产高度数字化,大模型能够直接感知实验状态并参与流程反馈,于是也催生了很多大模型赋能 AI 研究的学术进展。
近日,我们团队发布了题为 AI4AIR: A Comprehensive Survey on Large Language Models for AI Research 的预印本综述论文。这篇综述聚焦 AI for AI Research(AI4AIR)这一正在快速兴起的方向,试图解答上述问题。
该研究面向人工智能当下主流的机器学习全流水线,构建了一个结构化的二维分类体系。一方面从领域导向视角覆盖主要 AI 研究的主流子领域,包括自然语言处理、计算机视觉、数据挖掘和通用机器学习;另一方面从流程导向视角沿着机器学习研究流水线展开,包括数据工程、模型设计与优化、模型评测,以及连接这些阶段的闭环自动化。在此基础上,我们在综述论文中提炼出大模型在 AI 研究中反复扮演的五种核心角色:标注员(Annotator)、合成器(Synthesizer)、优化器(Optimizer)、评测员(Evaluator)和编排者(Orchestrator),系统展示了它们如何在 AI 研究流程的各个阶段协同发挥作用。我们揭示了一个重要趋势:LLM 已不再仅仅是 AI 研究者手中的工具,而是正在成为 AI 研究流程本身的一部分。
论文题目:
AI4AIR: A Comprehensive Survey on Large Language Models for AI Research
项目主页: https://ict-find-lab.github.io/Awesome-LLMs-for-AI-Research
GitHub 链接: https://github.com/ICT-FinD-Lab/Awesome-LLMs-for-AI-Research
论文作者:
敖翔,连俊宏,李翰洋,王思懿,乔伊然,乔怡,许嘉祺,何清,程学旗
摘要
在 AI 研究领域,依托语言实现的自动化技术,正逐步弥补传统以人为核心、试错迭代的科研模式短板。在各类 AI 工具中,大模型已成为科研工作流中实现内容生成、知识整合与逻辑推理的核心载体。现阶段,大模型虽已广泛应用于文献综述、学术写作等通用科研场景,但学界尚未系统、深入地探究其在 AI 研究全生命周期中的具体作用与深层价值。
为填补这一研究空白,本文提出 AI4AIR,即 AI for AI Research,系统性综述大模型在机器学习研究流水线中的核心应用与价值。本文构建了一个结构化的二维分类体系。其中一个维度覆盖主要 AI 研究领域,包括自然语言处理、计算机视觉、数据挖掘和通用机器学习;另一个维度沿着机器学习研究流水线展开,包括数据工程、模型设计与优化、模型评测,以及跨阶段闭环自动化。
基于该研究框架,本文凝练出大模型在科研流程中高频复用的五大核心角色,分别为标注员、合成器、优化器、评测员与编排者,厘清了各类角色参与 AI 研究工作流的具体路径。同时,文章系统剖析了当前 AI4AIR 领域的核心瓶颈,包括数据污染、模型幻觉、反馈驱动场景下的可靠性缺失等问题,并针对性展望研究方向,旨在进一步提升 AI 科研与技术发现的效率及可靠性。
关键词: Large language models, artificial intelligence research, machine learning pipeline, AI for AI research.
引言
历经数百年发展,以人为核心的科研范式已形成成熟且标准化的研究流程:从科研问题挖掘、文献梳理、研究假设提出,到实验方案设计、实证结果验证,最终通过同行评议论文完成科研成果的公开传播。近年来,伴随大模型技术的飞速迭代,越来越多的 AI 研究者将其融入传统科研范式,革新现有研究模式。
近两年来,相关研究成果呈井喷式增长,学界已可依托大模型完成文献综述撰写、科研问题挖掘、定理推导证明、实验方案设计等各类科研工作,大幅助推多学科的科学创新与技术突破。AI 赋能科研的价值也获得了权威认可,2024 年诺贝尔物理学奖与化学奖均表彰了多项 AI 驱动的前沿科学突破,通用 AI 科研工作流的相关综述也已有完备研究可供参考。
除了赋能通用科研场景,大模型也正在从根本上重塑 AI 研究本身。其应用价值不再局限于文献整理、文稿撰写等外围辅助工作,而是凭借强大的内容生成能力、海量预训练知识与进阶逻辑推理能力,深度渗透 AI 研究核心环节,带来颠覆性的范式升级。
具体而言,大模型可生成机器学习模型训练所需的合成数据,有效解决低资源场景下的数据获取与标注难题。同时,诸多前沿研究直接将大语言模型作为预测模块,替代传统 AI 模型完成各类任务。以 GPT-4o 为代表的先进大模型,还可充当专业专家评测主体,完成各类自研 AI 模型的性能评估工作。各类场景的探索充分印证一个核心趋势:大模型已成为 AI 研究在数据处理、模型构建、性能评测全环节的核心基础组件。
基于上述现状与研究观察,本文旨在围绕一个核心研究问题建立系统性视角:
LLM 如何为 AI 研究作出贡献?
为回答这一问题,本文全面综述了近年来的相关文献,并构建了一个分类体系,用于归纳 LLM 在 AI 研究中的多样化角色。为了保持范围聚焦,本文重点关注机器学习模型设计相关研究,因为它代表了目前 AI 研究社区中的主流且关键方向。
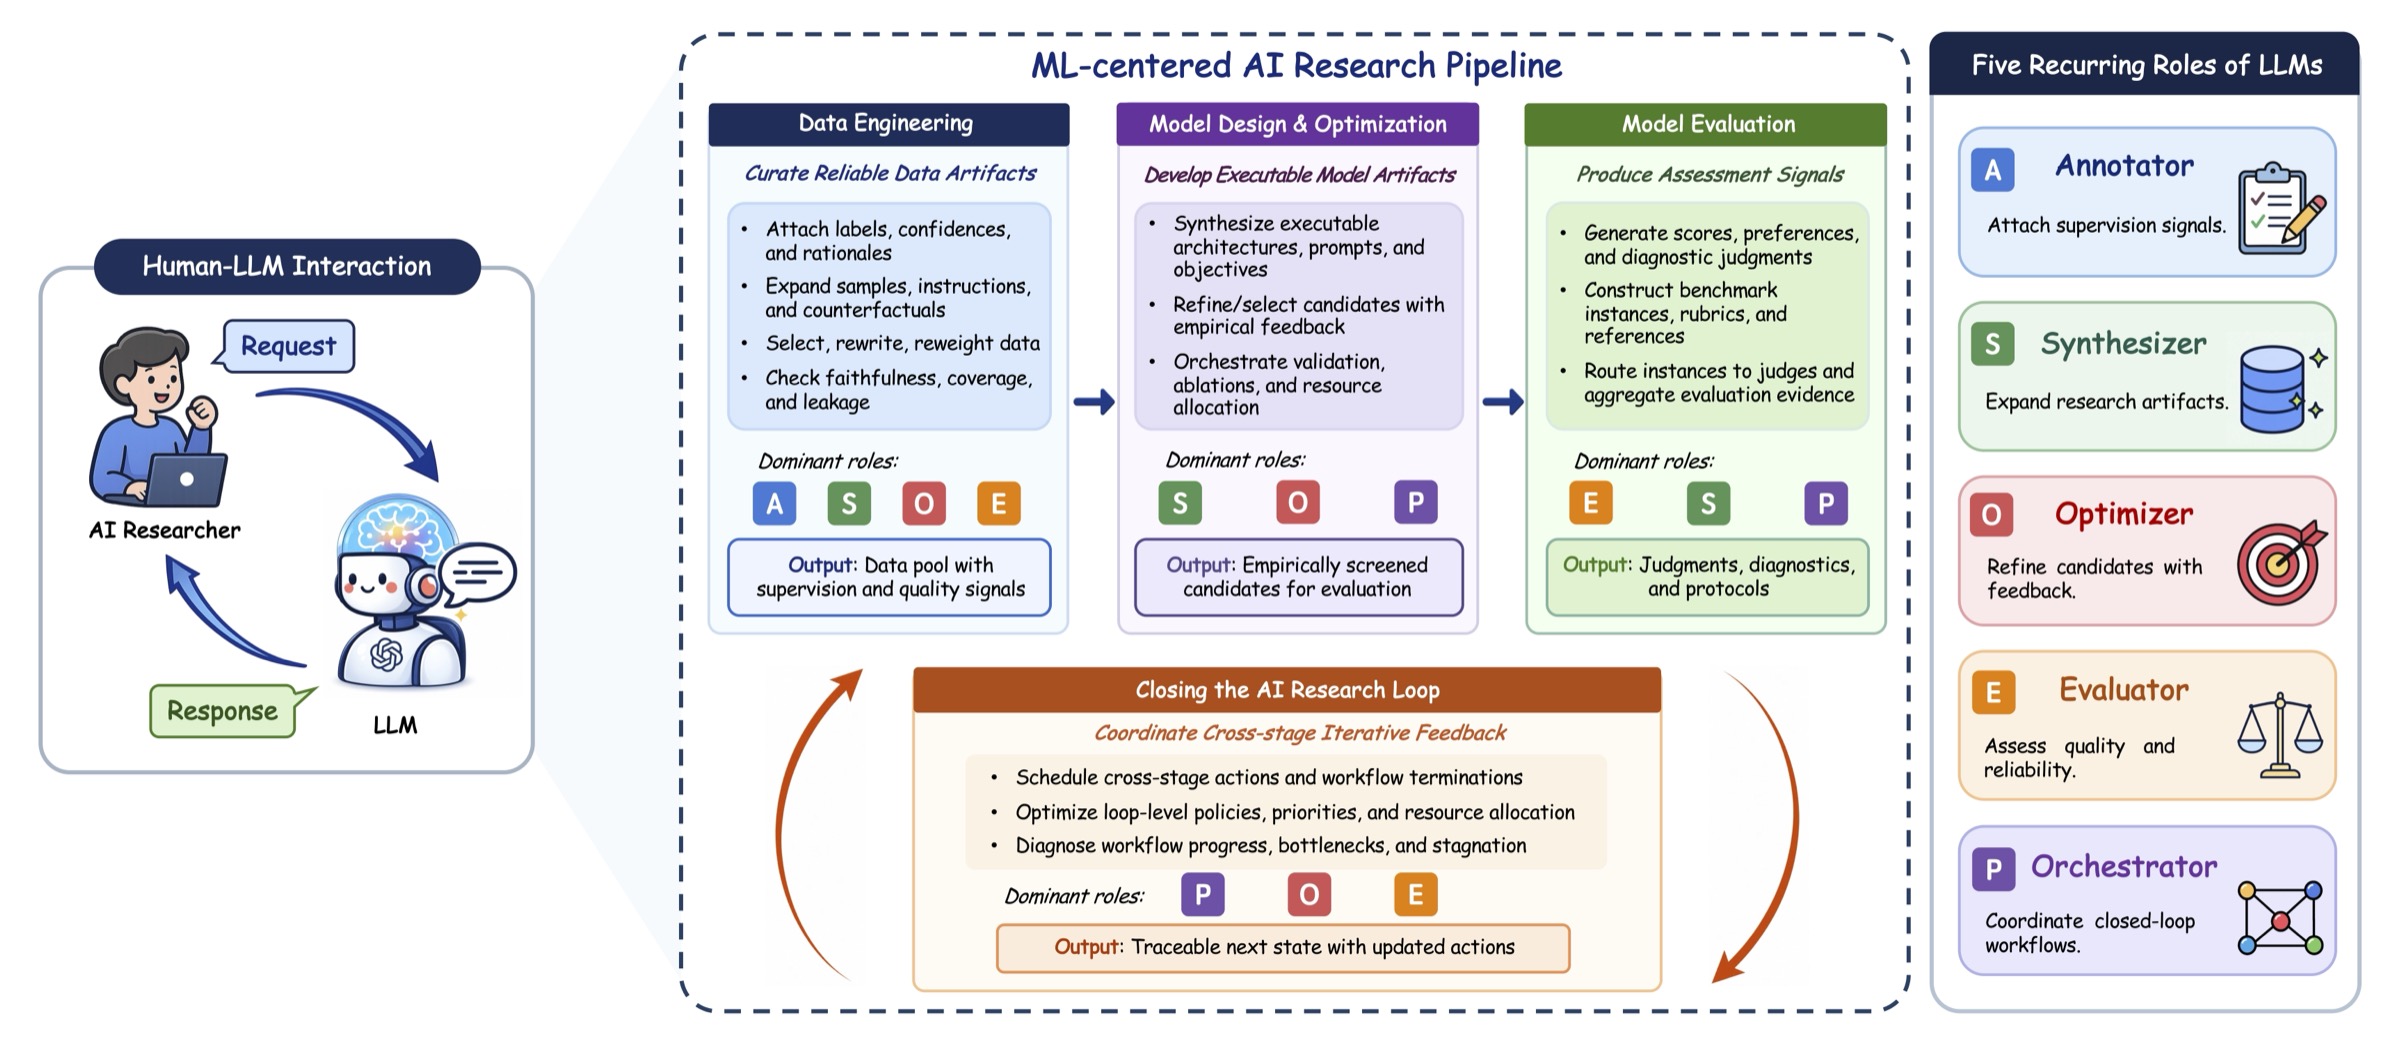
标准化机器学习研发流水线主要包含数据工程、模型设计与优化、模型评测三大核心阶段。在此基础上,本文进一步探究大语言模型对科研工作流自动化编排的赋能作用,完善 AI 研究闭环迭代体系。基于这一研究架构,本文系统总结大模型在机器学习类 AI 研究全流程中的核心角色,梳理当前研究瓶颈,展望未来研究方向。图 1 直观展示了迭代式机器学习驱动的 AI 研究全生命周期,也清晰界定了 AI4AIR 的核心内涵:前一个 AI 指 AI 工具,而 AIR 指 AI 研究。
据我们所知,此前还没有综述系统考察大模型在 AI 研究全流程中的多元角色与交叉应用。现有针对计算机视觉、推荐系统、图学习等单一 AI 子领域的综述,仅聚焦大模型对特定任务性能的提升效果与专属模型的构建方法;AutoML 相关综述则以传统数值优化技术为核心,忽视了大模型语义推理能力带来的技术革新。同时,现有的大模型驱动机器学习工作流的综述,多局限于通用 AutoML 场景,未对大模型在不同科研阶段的差异化角色进行拆分界定。
此外,现有技术性综述多聚焦检索增强生成、参数高效微调等技术,重点剖析模型架构、训练与推理的优化设计,而非针对 AI 科研工作流本身。广义的 AI for Research 相关研究,也仅聚焦科研前期的假设生成、与后期的论文撰写等环节,与本文聚焦的机器学习核心研发流程存在差异。
总体而言,现有相关研究要么局限于单一 AI 子领域,要么仅覆盖通用科研辅助场景。仍缺少一套完整、体系化的视角,来理解 LLM 在整个 AI 研究生命周期中的多面角色。
本文的主要贡献如下:
据我们所知,本文是首篇系统梳理大模型在以机器学习为中心的 AI 研究中作用的综述,并从 AI 研究生命周期的角度提供了结构化视角。
本文基于 LLM 在机器学习模型设计与开发中的角色构建分类体系,并系统归纳了已有相关工作。
基于综述结果,本文梳理了当前研究中的瓶颈,并讨论了利用先进 AI 工具提升 AI 研究效率与效果的可能方向。
概述
为方便读者快速抓取论文核心精髓,我们对原文进行精简提炼。更详尽的细节可阅读原始论文。
范围与定义
AI 研究涵盖广泛的子学科,从硬件加速、类脑计算,到符号推理和控制系统。本文明确将范围收窄到以机器学习模型设计为中心的 AI 研究:即通过标准流水线开发机器学习模型的过程,包括数据工程、模型设计与优化和模型评测。
为什么关注以机器学习为中心的 AI 研究?
物理世界中的科学发现通常面临所谓的“湿实验室瓶颈”。也就是说,一个假设必须通过耗时的物理实验才能得到验证。相比之下,以机器学习为中心的 AI 研究主要运行在数字空间中。数据集构建、模型实现、训练配置和评测指标本质上都是机器可读的数字化数据,LLM 可以直接读取研究状态、生成可执行代码并接收实验反馈。这种特征让机器学习研究天然适合被组织为如下循环:
读取当前研究状态 → 生成候选方案 → 执行实验或评测 → 获得反馈 → 更新下一步研究动作。
这也是 AI4AIR 与许多 AI4Science 工作的重要区别。AI4AIR 并不只关心 LLM 如何帮助科学家提高写作效率或文献阅读效率,而是关注 LLM 如何进入机器学习模型研发流程本身。
分类体系
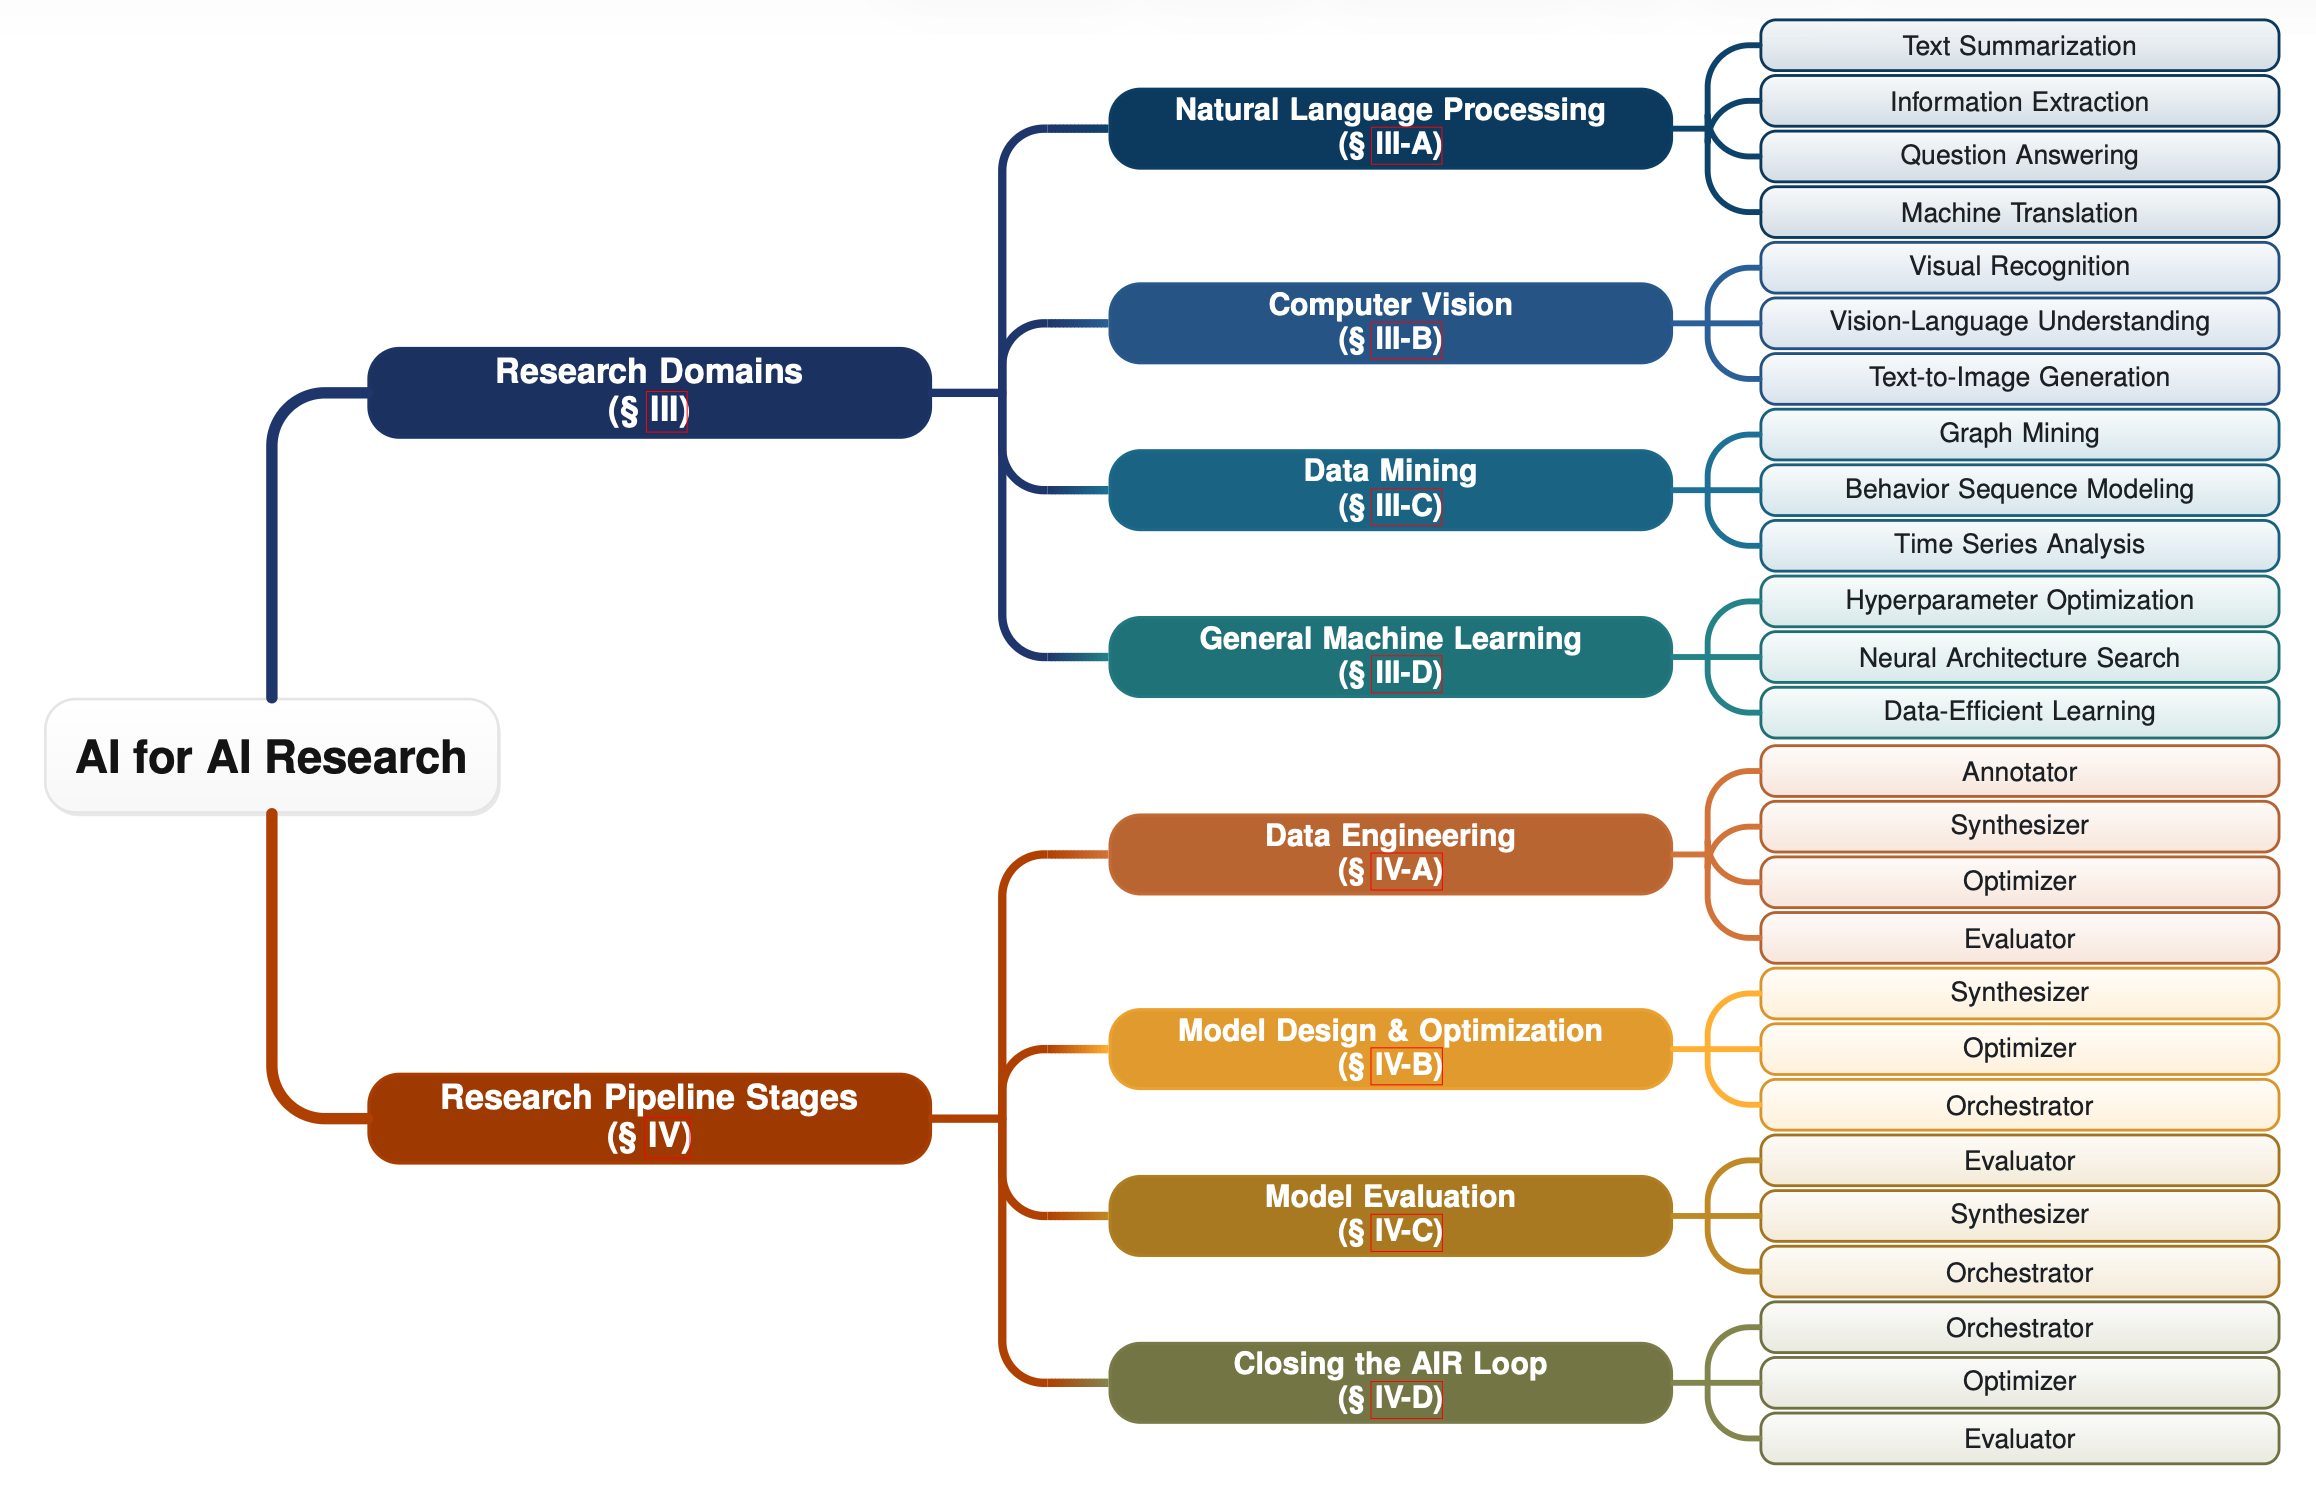
本文提出图 2 所示的层级分类体系,从两个互补维度覆盖 AI4AIR 研究场景:
- 领域导向视角:覆盖自然语言处理、计算机视觉、数据挖掘、通用机器学习四大主流 AI 领域,系统梳理 LLM 在不同研究场景、不同数据形态下的落地应用与核心价值。
- 流程导向视角:跳出单一任务局限,将所有研究成果回归机器学习研发流水线,提炼 LLM 在科研流程中的核心角色。
文献收集与筛选
为了确保综述文献的覆盖度和相关性,我们检索了 2020 年至 2025 年发表的代表性论文。具体而言,我们使用 Semantic Scholar API 和 Google Scholar 检索了这一时间段内发表的候选论文。把“large language model”、“LLMs”等关键词,和数据增强、标注、模型设计、优化、评估等描述研究角色的词组合起来搜索。同时从 DBLP 收集近三年的顶会论文,并基于标题关键词匹配检索潜在相关工作。去重后,截至 2025 年 6 月 30 日,共获得 1,440 篇候选论文。
随后,我们进行了两阶段筛选。第一阶段,通过设计任务提示和 few-shot 示例,我们使用 LLM 依据每篇论文的标题和摘要,进行粗粒度筛选。这一步主要移除非英文论文,以及那些没有将 LLM 作为研究工作流一部分的论文,共移除了 778 篇明显不在本文范围内的论文。第二阶段,我们对剩余论文进行人工检查,只留下大模型在机器学习研究里起实质作用的论文,再经验性补充了少量漏掉的相关工作,同一研究有多个版本时优先引用最完整的版本。最后,本文还补充了少量可能被关键词检索遗漏的相关研究,以避免忽略重要贡献。
两个视角,五种角色
从整体结构上看,AI4AIR 提供了两个互补视角。
第一个是领域导向视角。论文按照自然语言处理(NLP)、计算机视觉(CV)、数据挖掘(DM)和通用机器学习(GML)四类 AI 子领域组织文献。这个视角回答的是:LLM 已经进入了哪些 AI 研究方向?在不同数据形态和任务目标下,它分别解决了什么问题?
例如,在 NLP 中,LLM 可以用于摘要评测、信息抽取标注、问答数据生成和机器翻译评估等;在 CV 中,LLM 可以生成细粒度类别描述、改写图像生成提示词、规划布局或构造视觉问答评测等;在 DM 中,LLM 可以连接图结构、分析用户行为序列和时间序列中的语义信息等;在 GML 中,LLM 则更多参与超参数优化、神经架构搜索和数据高效学习等。
第二个是流程导向视角。论文将视角重新放回机器学习开发流水线中。跳出具体任务,该视角将 LLM 定义为可嵌入机器学习研发全流程的标准化功能模块,贯穿数据工程、模型研发、性能评测、闭环迭代全链路,具体分为五大角色:
标注员(Annotator):为原始数据补充各类监督信号,包括类别标签、伪标签、偏好标签、语义属性与推理解释。适配人工标注成本高的场景,大幅降低数据制备门槛。
合成器(Synthesizer):扩充科研素材体量与维度,可自主生成训练样本、反事实数据、指令集、评测样例、模型结构草案与提示词方案,有效缓解数据稀缺、长尾样本不足、任务格式缺失等难题。
优化器(Optimizer):基于实验反馈迭代优化候选方案,对模型、数据、策略进行筛选、改写、权重调整与迭代修正,核心聚焦优化成果在后续训练、评测中的实际落地效果。
评测员(Evaluator):构建全方位的智能评测体系,自动生成量化评分、偏好排序与问题诊断,覆盖模型输出质量校验、事实一致性核查、安全性与推理能力评估,同时可核验数据集与评测方案的可靠性。
编排者(Orchestrator):统筹调度完整科研流程,根据实验状态与反馈,智能决策下一步动作:补充数据、迭代模型、开展评测、调用工具、申请人工介入或终止无效实验,是实现 AI 科研闭环自动化的核心。
需要注意的是,五大角色与科研阶段并非一一绑定,单一流程可叠加多个角色,一个 LLM 也可同时兼顾多重功能。同时论文提炼出关键规律:LLM 赋能 AI 科研的深度,取决于其成效的验证成本。
这也解释了当前的行业现状:数据制备、模型评测环节的 LLM 赋能技术已相对成熟;而模型设计、训练优化、全流程闭环编排仍存在较大挑战,核心原因是这类任务验证成本高、反馈延迟长、效果归因难度大。
总结
本综述提出 AI4AIR 框架,梳理了 LLM 在机器学习类 AI 研究全生命周期的赋能模式,覆盖数据工程、模型设计与优化、模型评测、闭环迭代四大核心阶段,归纳出标注、合成、优化、评测、编排五大核心角色的功能范式。通过这些角色,LLM 帮助构建和完善研究产物,支持模型开发决策,辅助评测,并协调迭代反馈。这些能力有望加速实验进程,让复杂的模型开发流程变得更加高效。与此同时,LLM 的更广泛应用仍需克服在可靠性、可解释性、偏差和可控性方面的持续挑战。因此,未来的 AI4AIR 系统需要在这些方面取得进展,尤其是在可验证性和人机协作工作流设计上。
欢迎阅读论文原文并提出批评意见,也欢迎在 GitHub 和项目主页持续关注我们围绕 AI4AIR 的最新讨论与资源更新。
本期责任编辑:敖翔
本期编辑:连俊宏、许嘉祺
留言评论